

COLUMN
コラム
「とりあえず繋ぐ」が一番危ない。MCPで社内システムをAIエージェントに渡す前に決める4つの設計判断
MCP(Model Context Protocol)を使って社内システムをAIエージェントに接続するプロジェクトが、この1年で一気に増えた。だが実務で最初につまずくのは実装そのものではなく、「そもそも何を、どこまで許可するか」という設計判断だ。MCP 認可設計を後回しにしたまま接続を進めると、権限を広げすぎたAIエージェントが想定外の操作を行うリスクを抱えたまま本番運用に入ってしまう。本記事では、社内システムをAIエージェントに渡す前に決めておくべき4つの設計判断を、HexabaseがCaptain.AIの実装で向き合ってきた論点から整理する。
MCPは"繋げば安全"にならない。認可設計を先に決めるべき理由
MCPのサーバー登録数はこの数年で急速に増え、WorkOSの分析によれば登録レジストリには数ヶ月で約2,000件のサーバーエントリが集まり、Slack・GitHub・Google・Salesforce・Stripe・HubSpot・Shopify・Notionといった大手SaaS企業が公式またはコミュニティ管理のサーバーを提供するまでに広がっている。
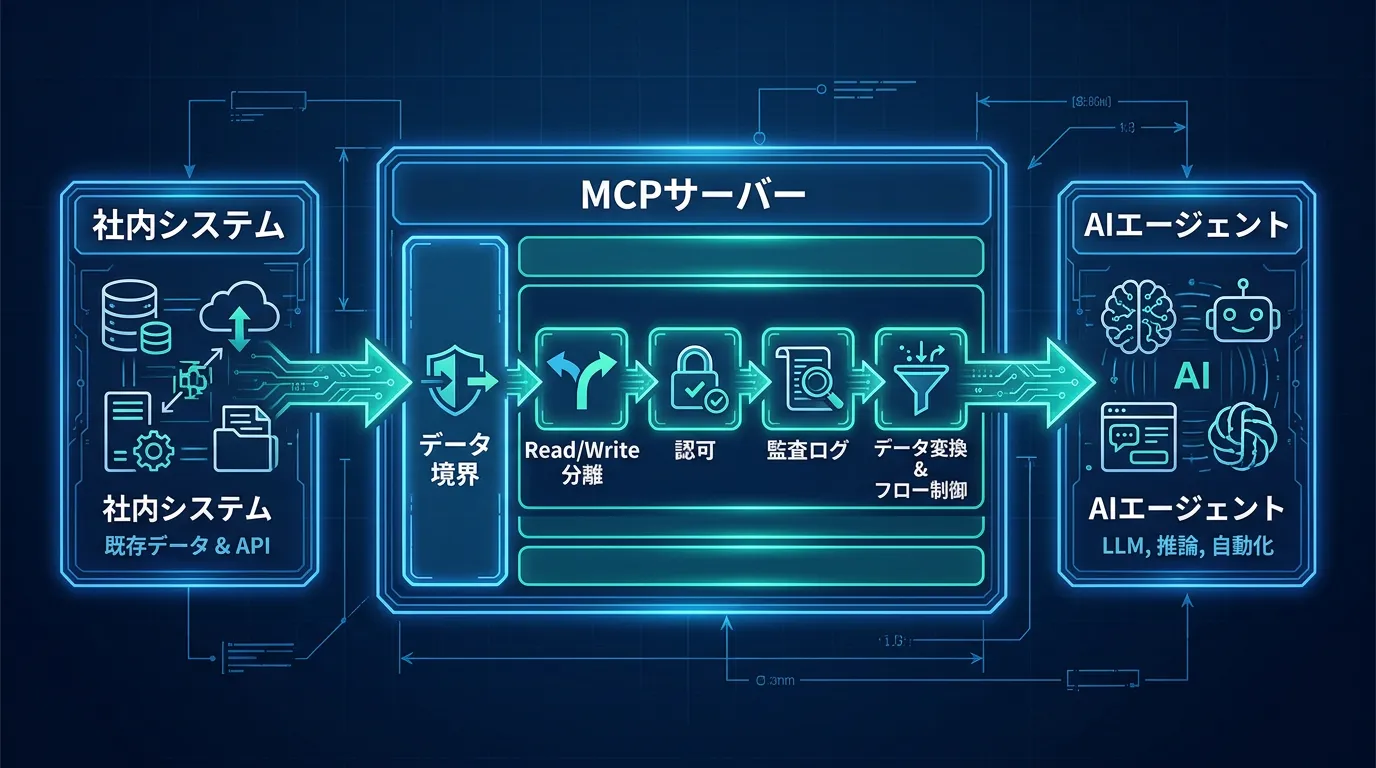
一方で見落とされがちなのが、プロトコル自体は安全性を保証しないという事実だ。MCPの公式仕様(2026-07-28版)は「ユーザーの明示的同意」「ツール実行は任意コード実行と同等に扱うこと」といった原則を明記しつつも、「MCP自体はプロトコルレベルでこれらの原則を強制できず、実装側が同意フロー・アクセス制御・監査を作り込む必要がある」と述べている。つまりMCPは通信規格であって、権限設計そのものは接続する側の責任として丸ごと残される。だからこそ「繋いでから直す」のではなく、「繋ぐ前に決める」ことが重要になる。以下の4つが、その最低限のチェックリストだ。
決めること①:どのデータを見せるか
最初に決めるべきは、AIエージェントに公開するデータの範囲だ。Writerのエンジニアリングチームの解説は「すべてのツールがすべてのAIクエリ・ユーザーに公開されるべきではない」と指摘し、顧客データは読み取りのみ許可し削除は禁止するといった、ロール単位でのデータ露出範囲の設計を推奨している。
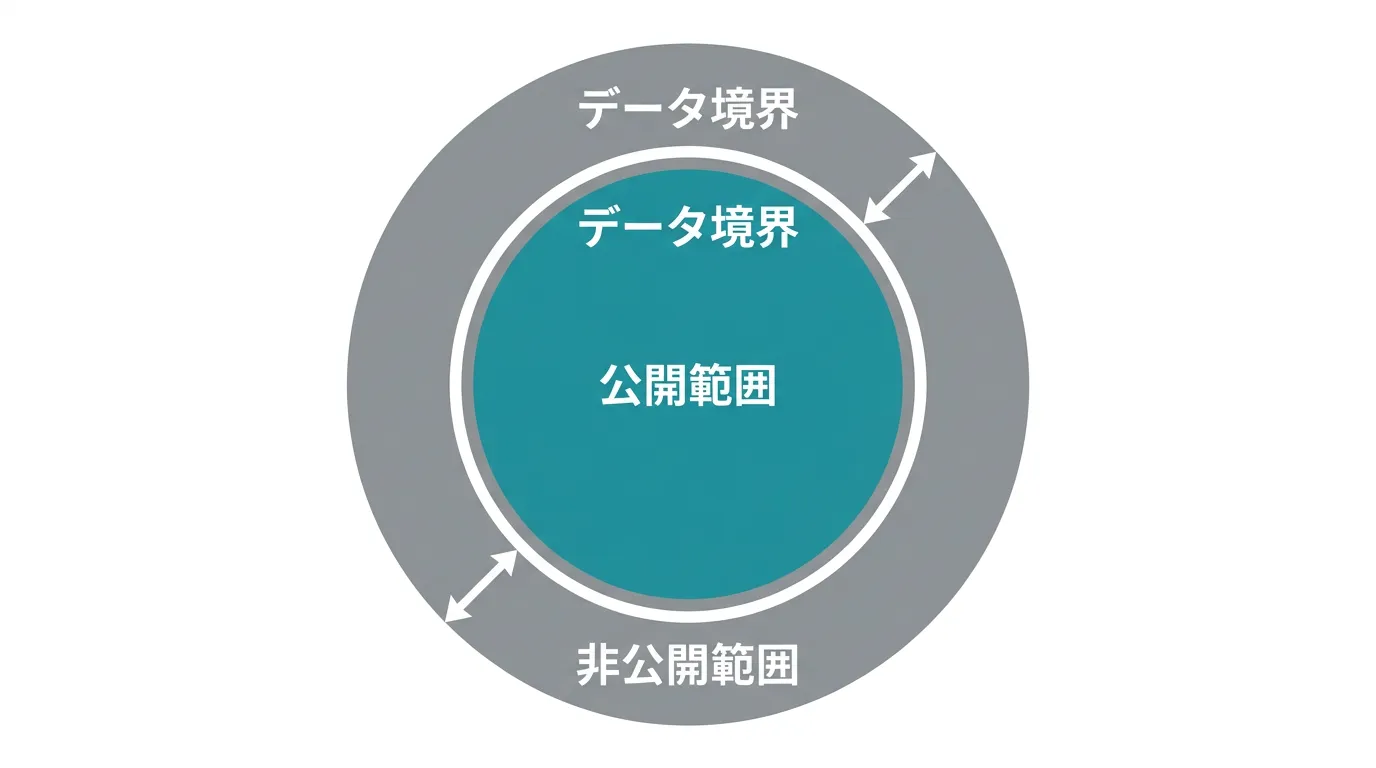
見落とされやすいのが、ツールの応答そのものが攻撃経路になりうる点だ。Checkmarxが整理したMCP特有のリスク一覧では、外部データに埋め込まれた隠れた指令をAIエージェントがそのまま実行してしまう「Context Poisoning(コンテキスト汚染)」が挙げられている。データ境界を決める作業は、「見せる/見せない」の線引きだけでなく、「返ってきた内容をどこまで信頼するか」まで含めて設計する必要がある。
決めること②:書き込みを許すか
読み取りと書き込みを同列に扱ってはいけない。IntuitionLabsのMCPパーミッション設計解説は、最小権限設計の実務手順として「状態変更を伴うアクションには確認を必須にする」ことを挙げ、MCP仕様自体も「破壊的なアクションには常に人間が介入し、ツール呼び出しを拒否できる能力を保つべき」としている。
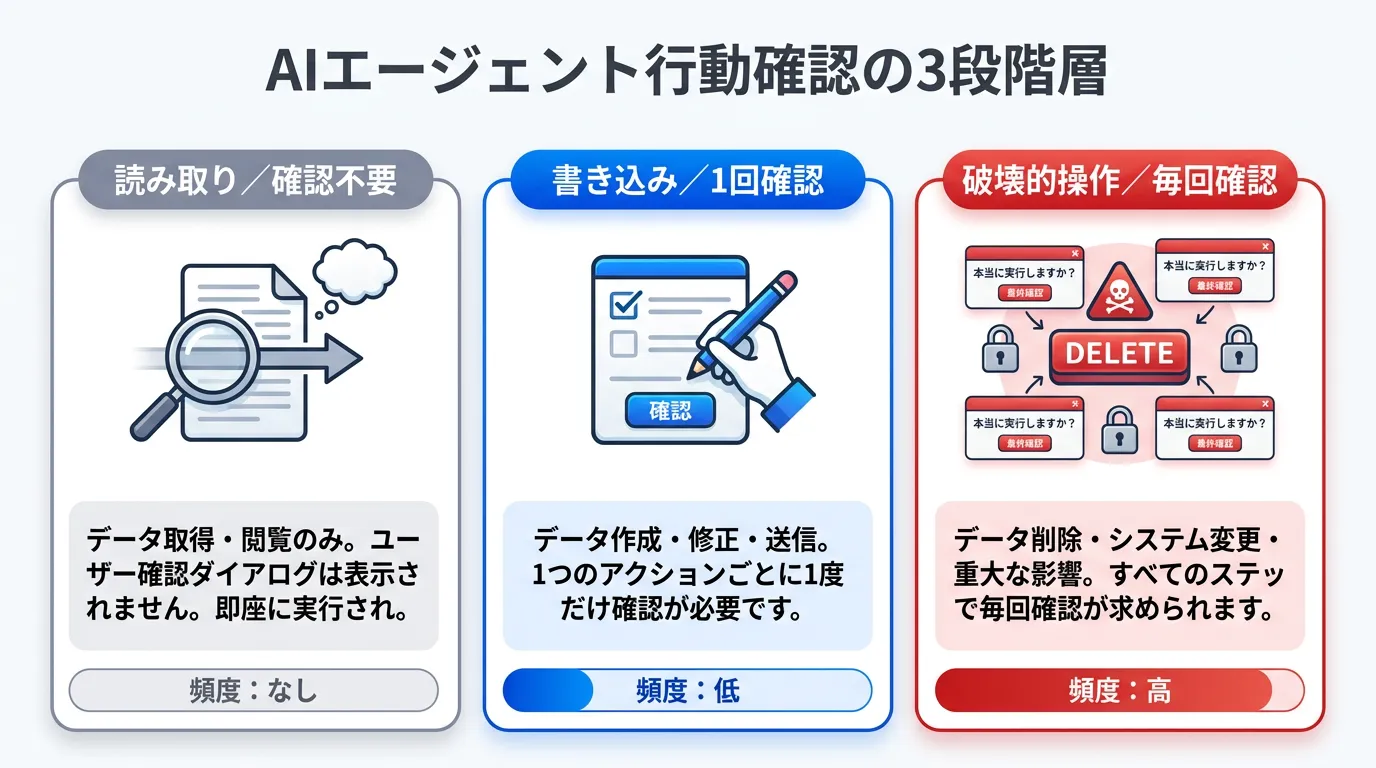
具体的な実装パターンとしては、AIエージェントのUI設計パターンを整理した記事が提示する「読み取りは確認不要、書き込みはセッション内で1回確認、破壊的操作は毎回確認」という3階層の分類がわかりやすい。すべての操作に確認を求めると承認疲労で読者が思考停止のままクリックするようになるため、階層化によって本当に重要な判断にだけ注意を向けさせる設計が重要になる。Waxellの分析も、書き込み・削除・送信系の高リスクツールにはタスク完了後に失効する短期トークンを使うべきだと指摘しており、Read/Write分離は権限の話であると同時にトークンのライフサイクル設計の話でもある。
決めること③:認可をどこで効かせるか
AIエージェント 権限設計の要となるのが、認可のチェックポイントをどこに置くかだ。WorkOSの認可パターン解説は、MCPの認可を「サーバー単位」ではなく「ツール単位」で設計すべきだと提唱する。各ツールが名前付きの権限をチェックし、セッションから組織IDを取得してすべてのクエリをテナントでフィルタする、という考え方だ。
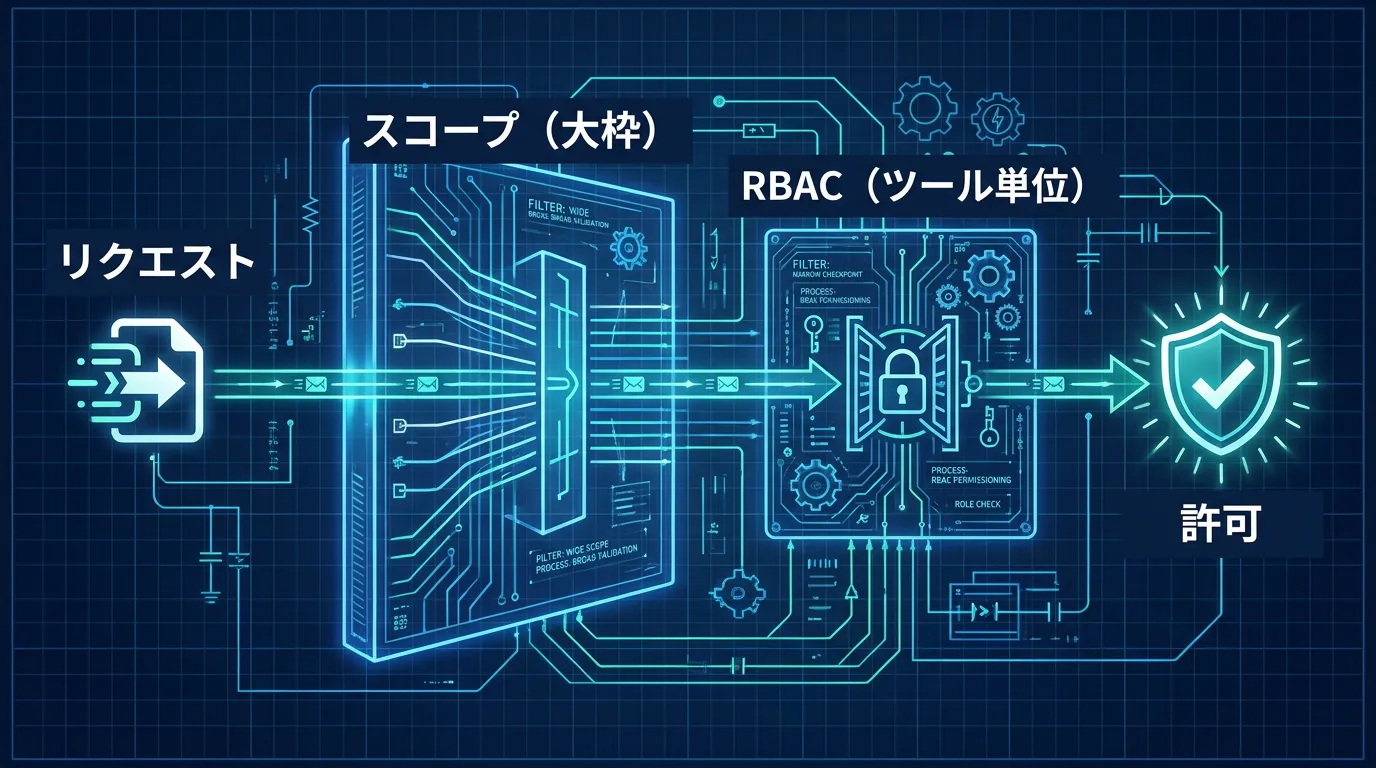
IntuitionLabsの解説が示す通り、実務では「スコープは大枠の境界、RBAC(ロールベースアクセス制御)はツール単位の実効性」という二層構造が定着しつつあり、主要なAIクライアントも「モデルではなくハーネス(実行環境)側で権限を実施し、サンドボックスやAPIゲートウェイ、OSレベルの制御に委譲する」設計を採っているという。この設計を怠ると、1つのツールが複数ユーザーの権限を混同して使ってしまう「Confused Deputy」問題につながる。実際、AIエージェントが正規の権限の範囲内でAPIを呼び出しただけなのに、OWASP API Security Top 10が定義するBOLA(Broken Object Level Authorization)、つまりオブジェクト単位の認可チェック漏れを突いて他人のデータを操作してしまう事故は、AIエージェント特有の形で顕在化しやすい。予測可能なIDを避け、リクエストのたびに「このユーザーは本当にこのオブジェクトを操作してよいか」を検証する設計が欠かせない。
決めること④:監査ログをどう残すか
最後の砦がMCP 監査ログだ。WorkOSの認可パターン解説は「変更を伴う操作はすべて監査ログAPIで記録し、セッションスコープの一時許可を推奨する」としており、Writerの解説も「AIがツールを使うたびに、誰が・何を・いつ呼び出したかをシステムが記録すべき」だと述べている。
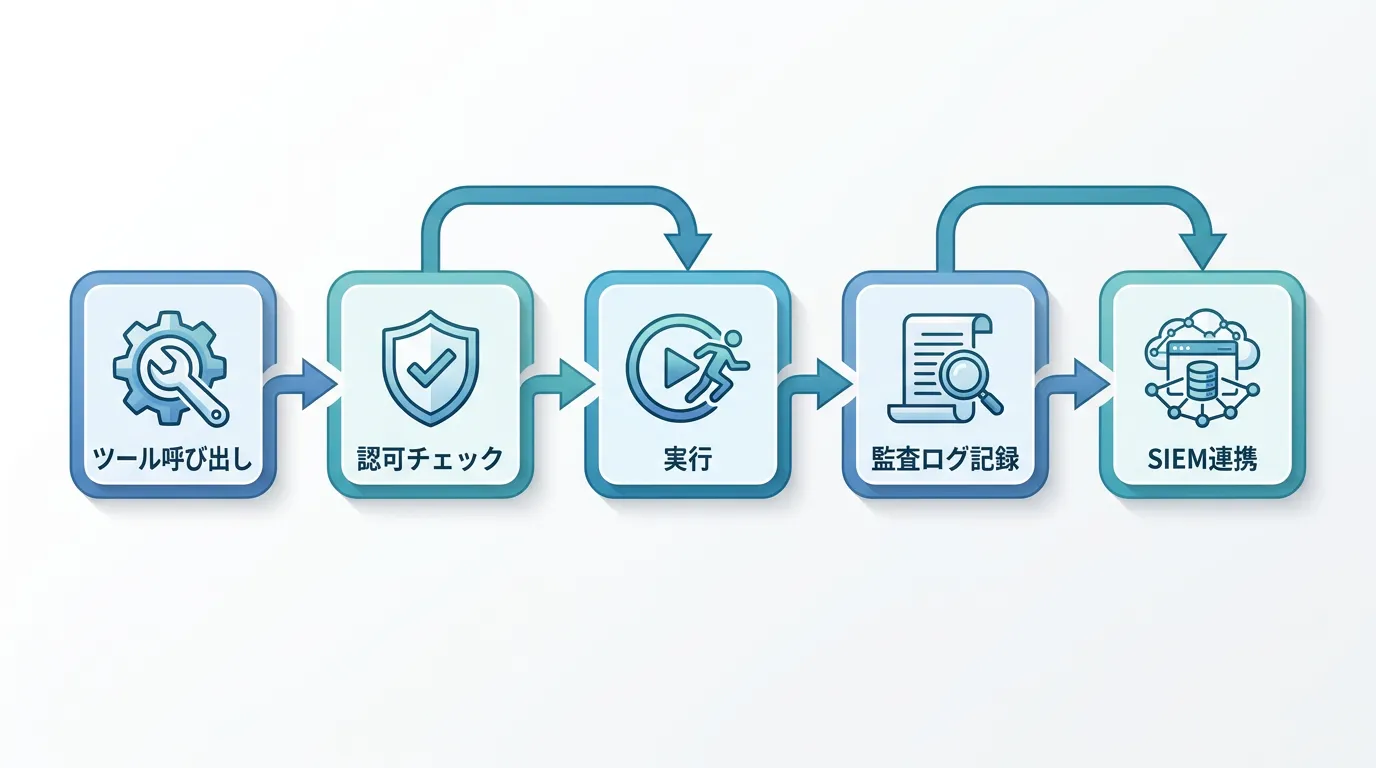
ここで注意したいのは、ネットワーク経路の監視だけに頼ると監査ログが穴だらけになる点だ。MCPサーバーの監査ログ設計を専門に解説した記事は、「MCP仕様自体はログを単なるデバッグ用ユーティリティとしてしか位置づけておらず、SOC 2やGDPR対応に必要な永続的な記録にはならない」と指摘し、標準入出力(STDIO)経由の実行はネットワークトラフィックを生まないためAPIゲートウェイでは検知できないという盲点も挙げている。有効な対策は、事後のネットワーク監視ではなく「実行前の認可チェックそのものを監査証跡の情報源にする」ことだ。誰が・どのリソースに・どんな判定結果で許可されたかを、権限確認の瞬間に記録してしまえば、後から推測に頼る必要がなくなる。
監査ログは事故対応のためだけの記録ではない。社内システムへのアクセスを情シス部門や監査担当が事後に説明できる状態にしておくことは、AIエージェント導入の可否を経営層に説明する材料そのものになる。ログをSIEMに連携し定期的にレビューする体制まで含めて設計しておけば、「AIが何をしたか分からない」という導入時の最大の不安に、具体的な答えを用意できる。
4つの判断を、権限設計として運用に落とし込む
ここまでの4つは個別の設定項目ではなく、「AIエージェントの操作範囲を機能単位で定義し、実行ログを追える状態にする」という一つの設計思想の異なる側面にすぎない。データ境界を決めても認可の効かせどころが曖昧なら意味がなく、Read/Write分離を決めても監査ログがなければ何が起きたか検証できない。
もう一つ実務で有効なのが、権限を最初から全開放するのではなく段階的に引き上げる考え方だ。Cloud Security Allianceが公開したAgentic Trust Frameworkは、AIエージェントの自律性を「読み取り専用のIntern」から「人間承認を経て実行するJunior」「定義された範囲内で自律実行するSenior」「ドメイン内で完全自律運用するPrincipal」まで4段階に分け、実績・セキュリティ検証・インシデント履歴を確認しながら権限を昇格させる設計を提案している。こうした権限管理やAPI認可設計の勘所を体系的に学びたい開発チームには、HexabaseのAI駆動開発伴走セミナーが実践的な入り口になる。
実装レベルでは、Captain.AIがMCP/Skillsを通じてAIエージェントの実行できる操作範囲を機能単位で細かく定義できる仕組みを備えており、PoCから本番までの段階的導入という設計思想を製品として体現している。「権限は"あとから絞る"もの」ではなく「最初から機能単位・段階単位で設計するもの」という考え方だ。またAIエージェントの実行環境そのものを本番から切り離しておきたい場合は、KuboのようなマネージドKubernetes基盤で検証環境を分離しておくことも、誤操作の被害を局所化する有効な補助策になる。
まとめ
MCPで社内システムをAIエージェントに繋ぐ前に決めておくべきことは、①どのデータを見せるか、②書き込みを許すか、③認可をどこで効かせるか、④監査をどう残すか、の4点に集約される。MCPというプロトコル自体は「AI⇄ツール」のやり取りを標準化するだけで、安全性を保証してくれるわけではない。この4つを接続作業の前に言語化しておくことが、後から権限を絞るコストを避ける最も確実な方法だ。
AIを"使う"フェーズはすでに終わりつつある。これからはAIと"協働"し、権限管理や監査まで含めて安全に働いてもらう設計力が、開発チームとDX推進部門の競争力を左右する。自社のMCP接続計画における権限設計を、Captain.AIの機能単位アクセス制御も参考にしながら棚卸ししたい場合は、まず無料相談から現状を整理してみてほしい。